Firma z branży drukarskiej · Druk / poligrafia
Aplikacja rosła razem z firmą przez półtora roku. Zaczynała się jako sprytny arkusz Google z paroma skryptami, a stała się centralnym systemem: zamówienia, wyceny, planowanie montaży, panel drukarni, panel partnera, mailingi, integracje. Wszystko trzymane w Google Sheets.
W pewnym momencie zaczęły dziać się rzeczy, których nie da się już naprawić kolejną poprawką w kodzie. Większe paczki plików dokładane do zamówienia potrafiły zawiesić aplikację. Zmiana statusu pliku bywała problematyczna, jeśli w tym samym czasie ktoś inny edytował coś obok. Aplikacja zaczęła „zamulać” i było jasne, że jednym plastrem tego nie zaklei.
Google Sheets w roli bazy ma jedną cechę, o której się nie mówi w tutorialach: przy każdym zapisie trzyma globalną kłódkę na cały arkusz. Jeden proces pisze – reszta czeka. Przy jednej osobie i kilku operacjach dziennie nic nie widać. Kiedy zespół się rozrasta i kilka osób w tym samym czasie klika statusy, wgrywa pliki i zapisuje notatki, robi się kolejka. Aplikacja nie jest wolna – ona czeka na swoją kolej.
Do tego dochodziły limity: 6 minut na wykonanie skryptu, ograniczenia API, brak sensownej historii zmian, brak indeksów. Rozwiązania punktowe (cache, batchowanie zapisów) kupowały czas, ale nie usuwały przyczyny.
Zamiast przepisywać całą aplikację od zera – co oznaczałoby miesiące pracy i realny dzień, w którym firma się zatrzymuje, żeby „przełączyć się na nowy system” – podeszłam do tego etapowo. Cel był jeden: klient ma pracować normalnie przez cały czas trwania operacji.
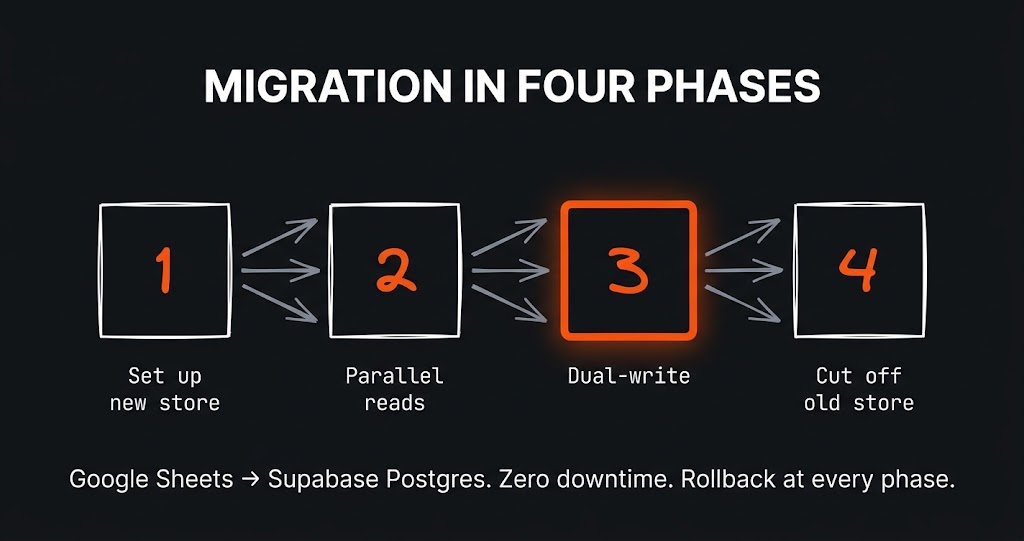
Rozbiłam migrację na cztery fazy, każda była samodzielnym stanem stabilnym. W dowolnym momencie można było się cofnąć bez utraty danych.
FAZA 1 - Nowa baza obok starej
   Postgres (Supabase) stoi obok arkusza. Aplikacja go nie widzi.
   Skrypty migracyjne przenoszą historyczne dane.

FAZA 2 - Odczyt równoległy
   Aplikacja czyta dalej z arkusza, ale te same widoki dostają
   drugi tryb: "przeczytaj z Postgresa". Klient nie widzi różnicy,
   ja porównuję wyniki.

FAZA 3 - Podwójny zapis (dual-write)
   Każda operacja pisze do OBU miejsc jednocześnie. Arkusz i baza
   są w idealnej synchronizacji. Jeśli coś padnie po jednej stronie -
   druga wciąż działa.

FAZA 4 - Odcięcie arkusza
   Aplikacja czyta i pisze wyłącznie do Postgresa. Arkusz zostaje
   jako archiwum na wypadek awaryjny.
Kluczowa decyzja: dual-write jako moment przejścia. To on daje spokój ducha. Zamiast „od jutra pracujemy na nowym systemie” mieliśmy okres, w którym dane leciały do obu miejsc równolegle. Można było porównywać, czy zamówienia w bazie zgadzają się z arkuszem. Klient dalej pracował normalnie.
Aplikacja przestała się wieszać przy większych operacjach i przy jednoczesnych zapisach. Drukarz może zapisywać statusy w tym samym momencie, w którym partner wrzuca nowe pliki – nikt nikomu nie blokuje. Większe paczki plików idą bez zawieszenia interfejsu.
Uczciwie: nie wszystko udało się przenieść od razu. Zdjęcia z zamówień dalej lądują w Google Drive – bo to działa i nie ma sensu tego ruszać, dopóki nie da się czegoś zrobić lepiej. To świadoma decyzja – migruje się to, co realnie boli, a nie wszystko naraz „bo migracja”.
Cała operacja rozłożona była na kilka tygodni. Firma pracowała normalnie przez cały ten czas – żaden użytkownik nie musiał się przełączać między systemami ani czekać na „dzień X”.
To wdrożenie opisałam też z trzech osobnych perspektyw na blogu, dla tych, których interesują mechanizmy pod maską:
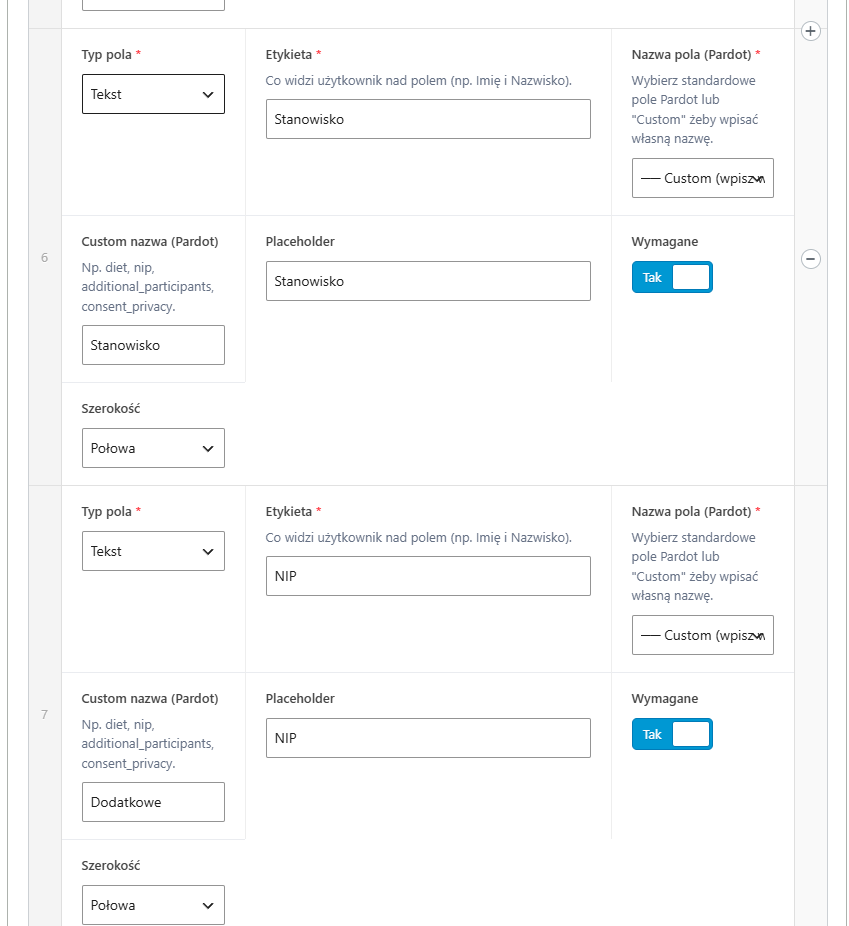
Wyzwanie Duży klient B2B miał na stronie wiele różnych formularzy – jedne do kontaktu, inne pod webinary, jeszcze inne pod eventy VIP. Za każdym razem…
Wyzwanie Pierwsza wersja tej strony powstała z odwagi. Napisałam o tym osobno – o perfekcjonizmie, który blokował, i o tym, że w końcu nacisnęłam „publikuj”. Postawiłam ją…
Wyzwanie Jak pokazać dane o bezdomności psów tak, żeby ludzie chcieli je czytać? To było moje wyzwanie. W marcu 2026 zgłosiłam się jako wolontariuszka…
Napisz, o co chodzi - nie musi być technicznie, od tego jestem ja. Odezwę się i powiem wprost, czy i jak mogę pomóc.